
Data leakage u modelima za predviđanje fudbalskih utakmica
Zašto modeli mogu izgledati bolje nego što zaista jesu
Modeli za predviđanje fudbalskih utakmica koriste istorijske rezultate, formu timova, očekivane golove, sastave, povrede, kvote i druge podatke kako bi procenili verovatnoću mogućih ishoda. Međutim, čak i napredni algoritmi mašinskog učenja mogu dati obmanjujuće dobre rezultate ako se u proces analize ušunja data leakage, odnosno curenje informacija.
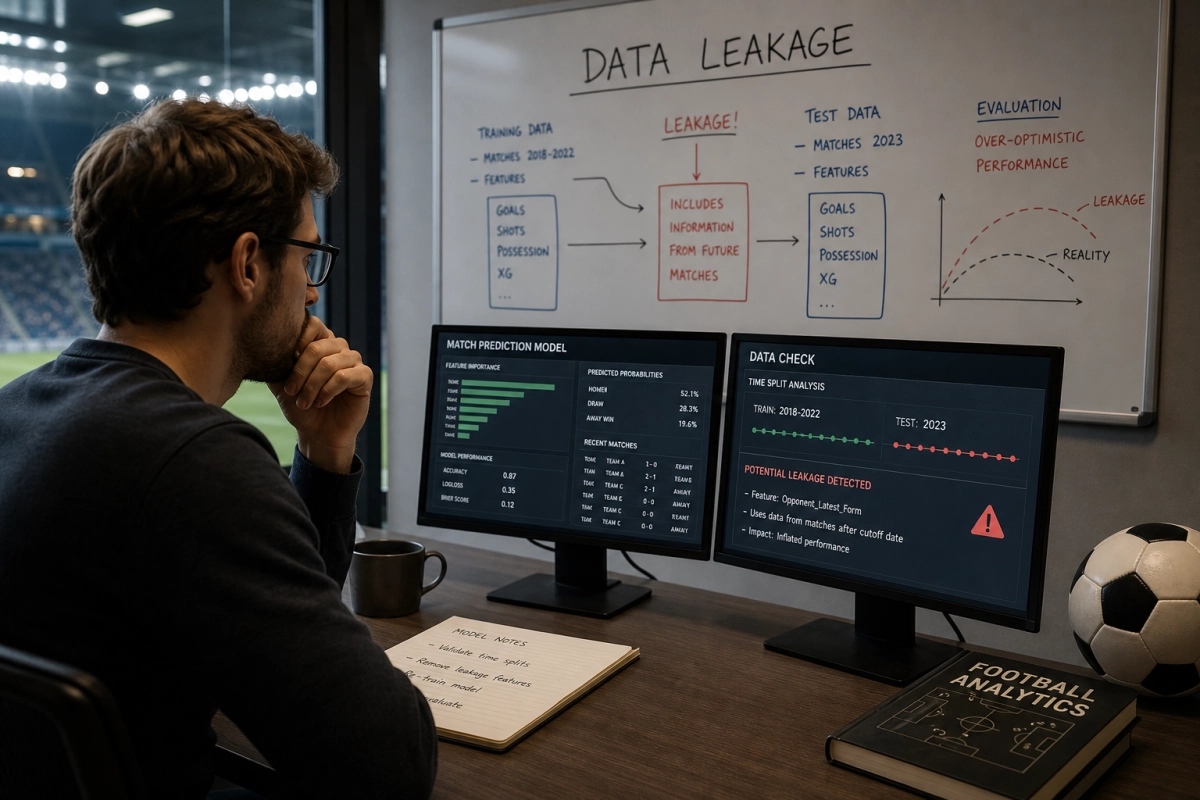
Data leakage nastaje kada model tokom treniranja ili testiranja dobije podatak koji u trenutku pre meča nije bio dostupan. Takav podatak može biti direktno povezan sa konačnim rezultatom ili skriven u načinu na koji su karakteristike izračunate. Model tada ne uči samo obrasce koji bi mogli da se pojave u budućnosti, već na određeni način „vidi“ deo odgovora.
U praksi to može da se dogodi kada se za procenu forme koristi cela sezona, uključujući utakmice odigrane posle posmatranog meča. Sličan problem nastaje kada se u karakteristike uključe konačni broj golova, post-match statistika ili ažurirane informacije o povredama koje su objavljene tek nakon početka utakmice.
Kako data leakage lažno ulepšava backtesting
Backtesting je simulacija rada modela na istorijskim utakmicama. Njegova svrha je da pokaže kako bi sistem radio na podacima koji su u prošlosti bili dostupni. Ako testni skup ipak sadrži buduće informacije, rezultat više ne predstavlja realan pre-match scenario.
Na primer, model može koristiti prosečan xG, odnosno očekivane golove, iz svih utakmica jedne ekipe u sezoni. Ako se predviđa meč iz njenog ranijeg dela, u taj prosek mogu biti uključene i kasnije utakmice. Isto važi za poziciju na tabeli, prosečnu formu, povrede, očekivane postave i tržišne kvote koje su se menjale nakon prvog objavljivanja.
Takav model može ostvariti visoku tačnost u testiranju, ali zato što je procenjivan u neprirodnim uslovima. Kada se primeni na novu utakmicu, bez pristupa budućim podacima, performanse često značajno oslabe. Zbog toga procenat pogođenih ishoda sam po sebi nije dovoljan. Potrebno je proveriti kako su podaci prikupljeni, kada su postali dostupni i da li su karakteristike izračunate bez gledanja unapred.
Najčešći izvori curenja informacija
- nasumična podela utakmica iz različitih perioda između treninga i testa;
- korišćenje post-match statistike, poput konačnih golova ili udaraca;
- računanje proseka forme na osnovu cele sezone;
- upotreba konačnih, a ne istorijskih kvota dostupnih pre meča;
- informacije o sastavima i povredama sa vremenskom oznakom posle početka utakmice.
U mašinskom učenju u sportu zato nije dovoljno izabrati algoritam poput logističke regresije, Poissonovog modela ili XGBoost-a. Ključno je prvo pravilno rekonstruisati informativno okruženje koje je postojalo pre svakog meča. U sledećem delu biće objašnjeno kako vremenska podela podataka, odvojeni skupovi i walk-forward validacija pomažu da se taj uslov dosledno ispuni.
Vremenska podela podataka kao osnova pouzdanog testiranja
Kod predviđanja fudbalskih utakmica podaci ne bi trebalo da se dele nasumično, kao što se često radi u klasičnim problemima mašinskog učenja. Utakmice imaju prirodan redosled: ono što se dogodilo u januaru moglo je biti poznato pre meča u februaru, ali ne i obrnuto. Zbog toga trening skup treba da sadrži samo ranije utakmice, dok testni skup obuhvata kasniji vremenski period.
Jednostavan primer je podela sezone na prve utakmice za trening, naredni blok za validaciju i završni blok za konačni test. Model se trenira na najstarijim podacima, podešava na narednom periodu, a zatim se procenjuje na utakmicama koje do tada nije „video“. Na taj način se imitira situacija u kojoj analitičar pre početka novog kola koristi samo prethodno dostupnu istoriju.
Važno je da se vremenska granica primeni na sve izvore podataka, a ne samo na tabelu rezultata. Ako se, na primer, sezonski prosek xG-a računa pre podele podataka, moguće je da i trening i test karakteristike već sadrže informacije iz budućnosti. Bezbednije rešenje je da se svaka karakteristika izračuna posebno za svaki meč, koristeći samo utakmice koje su mu prethodile.
Walk-forward validacija i odvajanje trening i test skupova
Walk-forward validacija dodatno približava testiranje stvarnom radu modela. U početnoj iteraciji model se trenira na ranijem periodu i predviđa naredni blok utakmica. Posle toga se taj blok može dodati u istoriju, model se ponovo trenira i zatim predviđa sledeći period. Proces se ponavlja kroz sezonu ili više sezona.
Ovakav pristup omogućava da se proveri da li model zadržava kvalitet kada se menjaju forma ekipa, treneri, sastavi i stil igre. Istovremeno se izbegava greška u kojoj se model jednom trenira na podacima koji obuhvataju ceo istorijski period, a zatim se njegovi rezultati predstavljaju kao da su nastali u realnom vremenu.
Trening, validacioni i test skup moraju imati jasno odvojene uloge. Trening skup služi za učenje parametara, validacioni za izbor karakteristika i podešavanje hiperparametara, dok testni skup treba sačuvati za završnu procenu. Ako se model više puta prilagođava rezultatima testnog perioda, taj period prestaje da bude nezavisan. Čak i kada se ne menjaju direktno parametri algoritma, izbor modela na osnovu test rezultata predstavlja oblik indirektnog curenja.
Posebnu pažnju zahtevaju standardizacija, imputacija nedostajućih vrednosti i izbor karakteristika. Srednja vrednost ili skala ne bi trebalo da se računaju na celom skupu podataka, već samo na trening delu, pa da se zatim primene na validaciju i test. U suprotnom, informacije o raspodeli budućih podataka mogu neprimetno dospeti u proces treniranja.
Simulacija informacija dostupnih neposredno pre meča
Najrealniji backtesting ne simulira samo datume, već i informativno okruženje pred utakmicu. Za svaki meč potrebno je definisati trenutak preseka, odnosno cutoff. Sve karakteristike, kvote, vesti i podaci o sastavima moraju biti ograničeni na informacije objavljene pre tog trenutka.
To znači da se povrede ne preuzimaju iz današnje baze kao konačna istorijska činjenica, već iz verzije ili zapisa koji pokazuje kada je informacija objavljena. Isto važi za početne postave. Ako su one zvanično objavljene nekoliko minuta pre početka, model koji simulira prognozu dan ranije ne sme da ih koristi. Moguće je napraviti dva odvojena scenarija: prognozu sa informacijama dostupnim 24 sata pre meča i prognozu neposredno pred početak.
Na kraju, rezultate ne treba meriti samo tačnošću. Brier skor, log-loss, kalibracija verovatnoća i profit nakon realističnih transakcijskih troškova mogu pokazati da li model zaista daje korisne procene. Ako se performanse značajno smanjuju kada se poštuje vremenski redosled i cutoff, to nije neuspeh testiranja, već važan signal da je ranija procena bila posledica curenja informacija.
Pouzdanost počinje disciplinom podataka
Najvredniji model nije nužno onaj koji ostvaruje najbolje rezultate u idealizovanom backtestingu, već onaj čije se ponašanje može objasniti i ponoviti u uslovima sličnim stvarnom radu. Svaka prognoza treba da bude zasnovana na jasno definisanom trenutku dostupnosti informacija, dosledno obrađenim podacima i postupku koji ne zavisi od naknadnog poznavanja ishoda.
Data leakage se često ne uočava kroz jednu očiglednu grešku, već kroz niz malih pretpostavki koje zajedno stvaraju nerealno povoljan rezultat. Zato provera vremenskog redosleda, porekla svake karakteristike i načina podele podataka mora biti sastavni deo razvoja modela, a ne završna formalnost.
Kada se analiza sprovodi konzervativno, slabiji rezultat može predstavljati veću vrednost od impresivne, ali nerealne tačnosti. Takav pristup omogućava da se ograničenja modela uoče na vreme, da se procene pravilno tumače i da se odluke zasnivaju na dokazima koji zaista mogu biti dostupni pre fudbalske utakmice.